

Check Point: с марта 2025 года количество фишинговых атак в Израиле выросло более чем в 4 раза
Согласно данным израильской компании кибербезопасности Check Point, с марта 2025 года в Израиле наблюдается резкий рост количества фишинговых атак с использованием SMS-сообщений, сообщает «Глобс».
Количество таких атак выросло в 4,4 раза. Основными объектами атак являются финансовые структуры – компания кредитных карт CAL, банк "Леуми", цифровой кошелек Bit, "Исракарт", банк "Апоалим" и Paypal.
Израильский национальный центр кибербезопасности сообщил, что обезвредил с начала года более 43 тысяч фальшивых ссылок, использованных в фишинговых атаках.
Фишинг — вид интернет-мошенничества, цель которого – получить персональные данные пользователя, такие как логины, пароли, номера кредитных карт, банковские реквизиты, и другие конфиденциальные сведения. Мошенники используют для этого поддельные сайты, электронные письма, социальные сети и другие онлайн-ресурсы, чтобы заставить пользователя добровольно раскрыть свою информацию.
newsru.co.il
Читайте также
Все материалы рубрики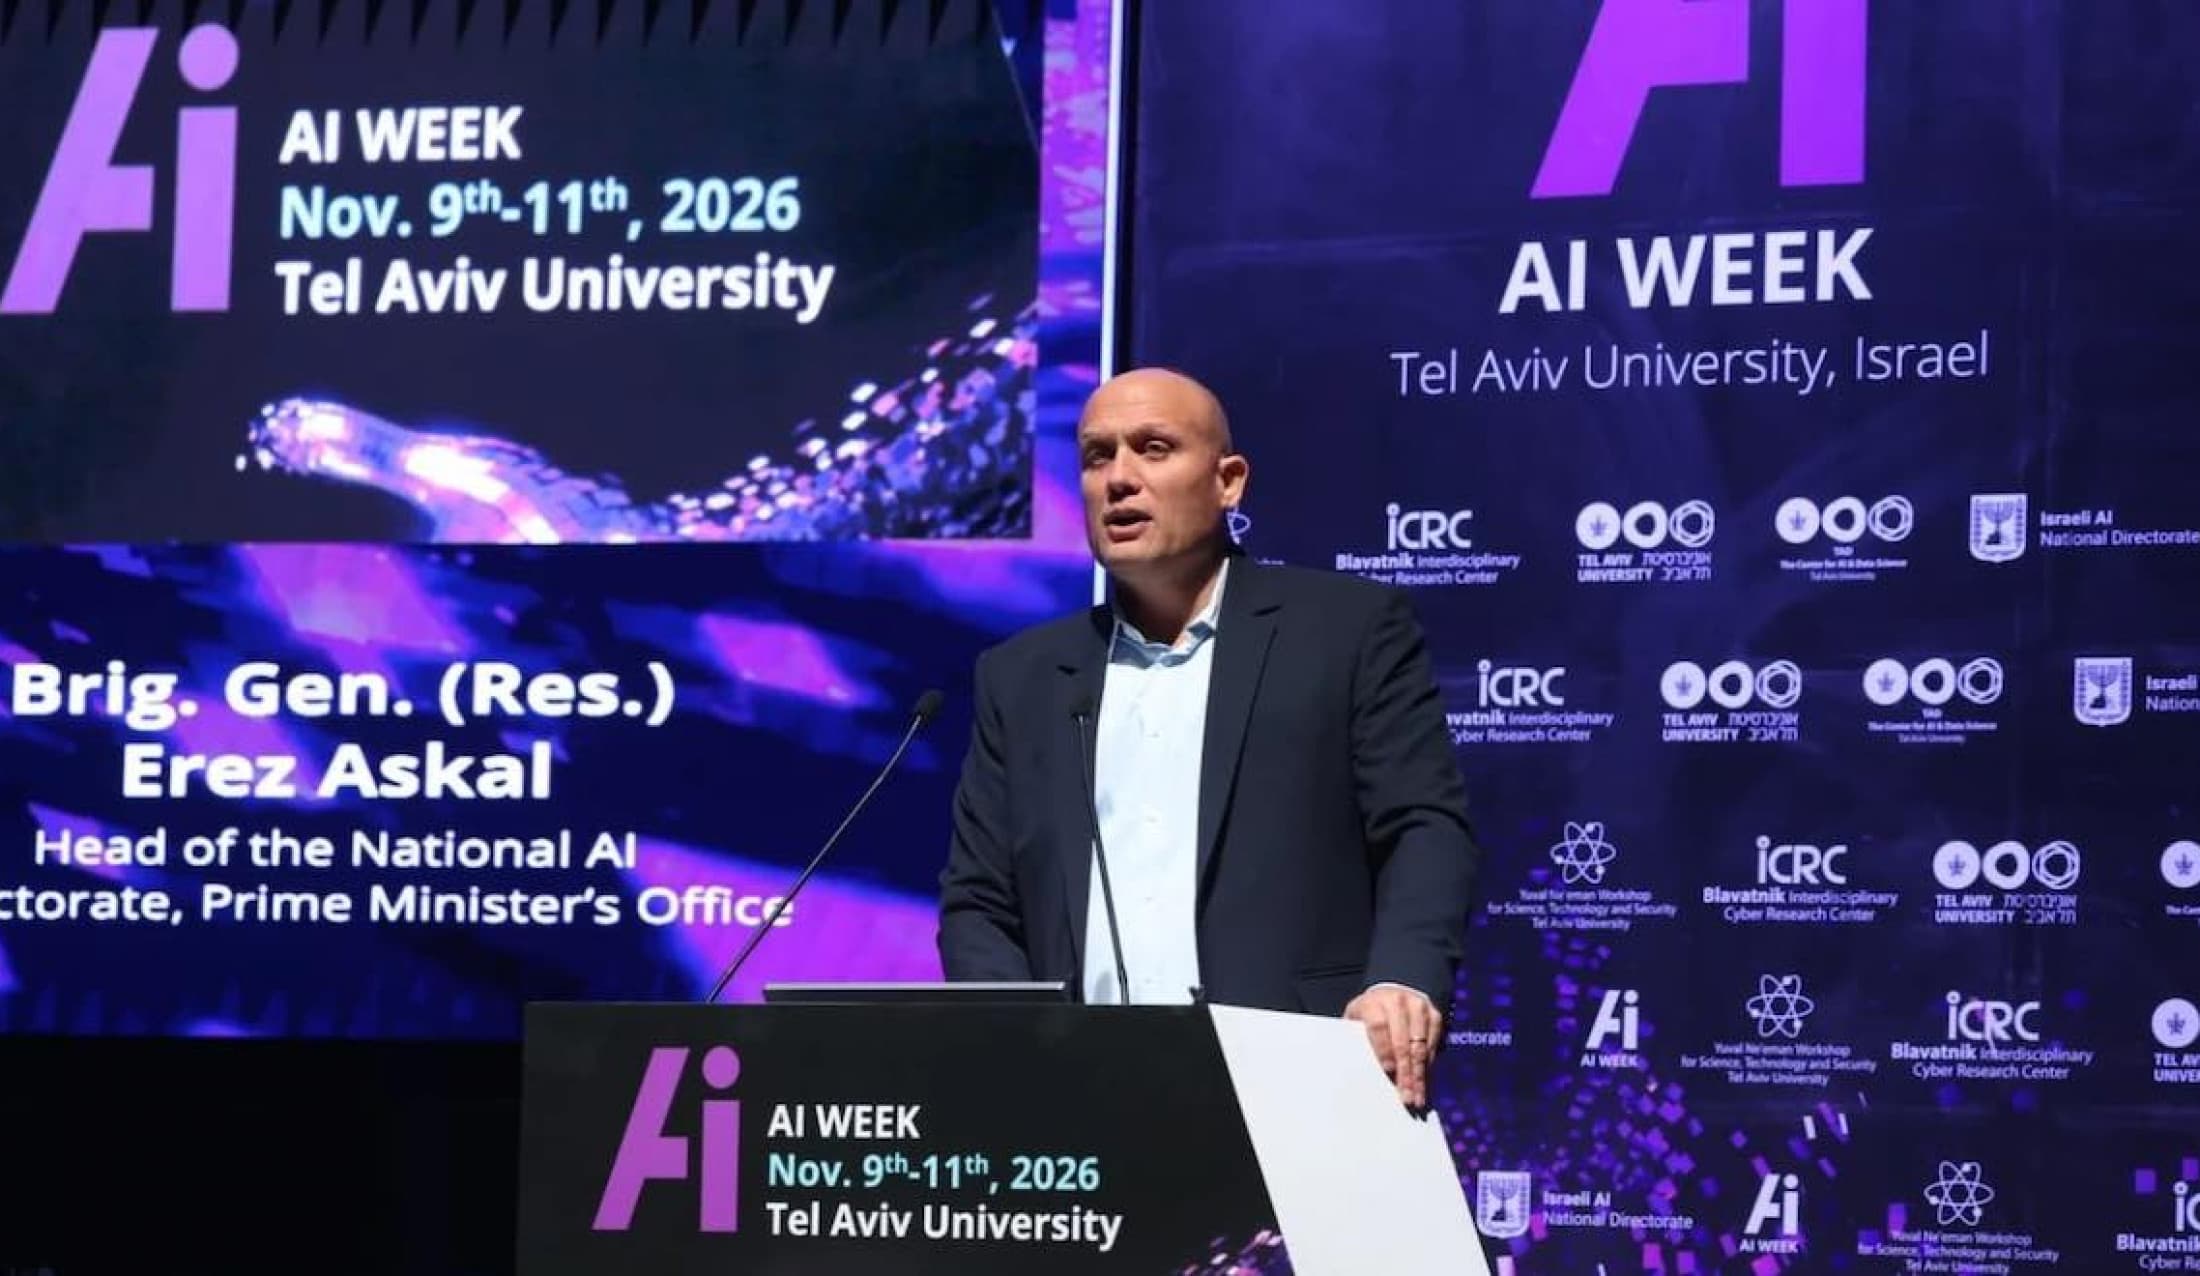 ТехнологииГлава Национального управления по искусственному интеллекту: Израилю нужна собственная ИИ-инфраструктура16:00, 9 ноября
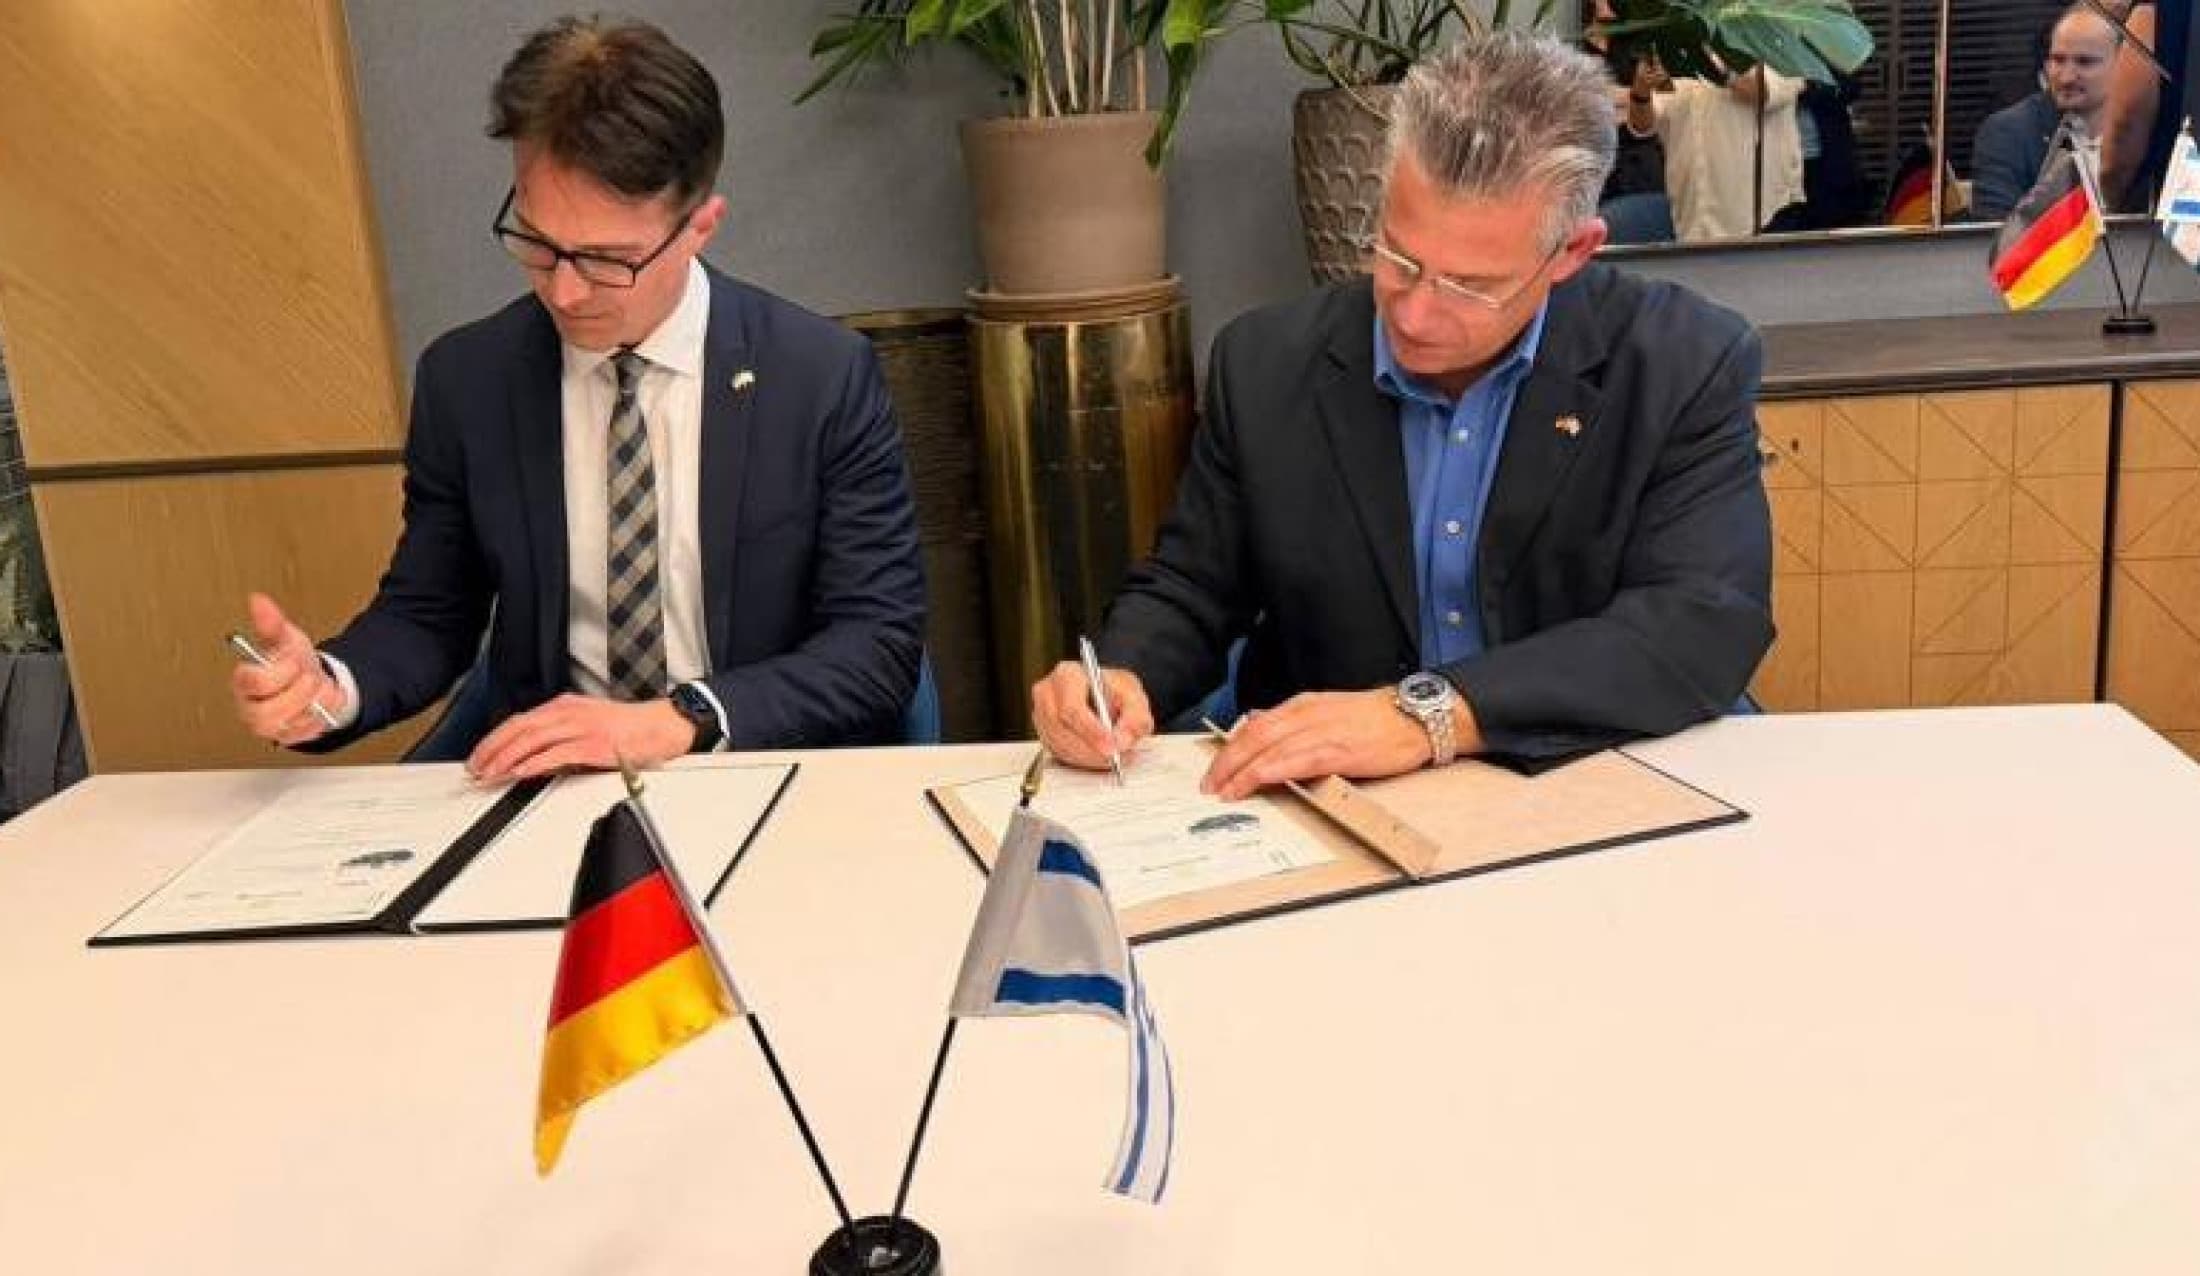 ТехнологииИзраиль и Германия продлили соглашение о сотрудничестве в сфере энергетики11:00, 6 ноября
 ТехнологииВ Израиле планируют построить первую геотермальную электростанцию на Голанских высотах15:00, 4 ноября
Ученые из Университета Бен-Гуриона показали, как чат-боты становятся опасными
Исследователи предупредили об угрозе «темных» ИИ
Специалисты Университета Бен-Гуриона опубликовали исследование, которое показывает: несмотря на многочисленные меры предосторожности, большинство современных языковых моделей остаются уязвимыми для манипуляций и могут выдавать запрещённую или вредную информацию.
Работа размещена на платформе научных препринтов arXiv.
Авторы исследования изучали как так называемые «тёмные» языковые модели — алгоритмы, созданные без фильтрации нежелательного контента, — так и популярных представителей вроде ChatGPT, которым уже внедрены механизмы цензурирования. Тем не менее, оказалось, что даже эти модели можно обмануть, используя специальные методы обхода фильтров — джейлбрейки.
Первоначально исследование было направлено на анализ использования незащищённых моделей для генерации контента порнографического характера с включением изображений реальных людей. Однако в ходе работы специалисты убедились, что уязвимыми остаются и многие общедоступные ИИ-инструменты. Методы обхода, обнародованные ранее, по-прежнему срабатывают, а новые способы появляются быстрее, чем разработчики успевают их нейтрализовать.
Наиболее тревожным открытием стало выявление универсального подхода к «взлому» языковых моделей, позволяющего систематически обходить защиту. С его помощью исследователи получали от чат-ботов пошаговые инструкции по осуществлению запрещённых действий: от взлома сетей и отмывания денег до инструкций по созданию взрывчатых веществ. Эти сценарии подтверждают растущий риск злоупотреблений — как со стороны конечных пользователей, так и через специально разработанные «тёмные» версии языковых моделей.
Учёные подчеркивают, что даже если такие модели не обучаются напрямую на запрещённой информации, часть нежелательного контента всё равно может проникать в их базу знаний в процессе обучения. На данный момент не существует надёжного технического способа полностью устранить это явление. Поэтому, по мнению исследователей, необходим более строгий и системный подход к фильтрации контента и ограничению возможностей моделей по интерпретации вредных запросов.
Результаты исследования вновь ставят перед разработчиками и регуляторами задачу — найти баланс между открытостью языковых моделей и эффективным контролем над потенциально опасной информацией.
cursorinfo.co.il