

Ученые: три сейсмостанции на юге Израиля регистрировали движение в Газе за полчаса до атаки 7 октября
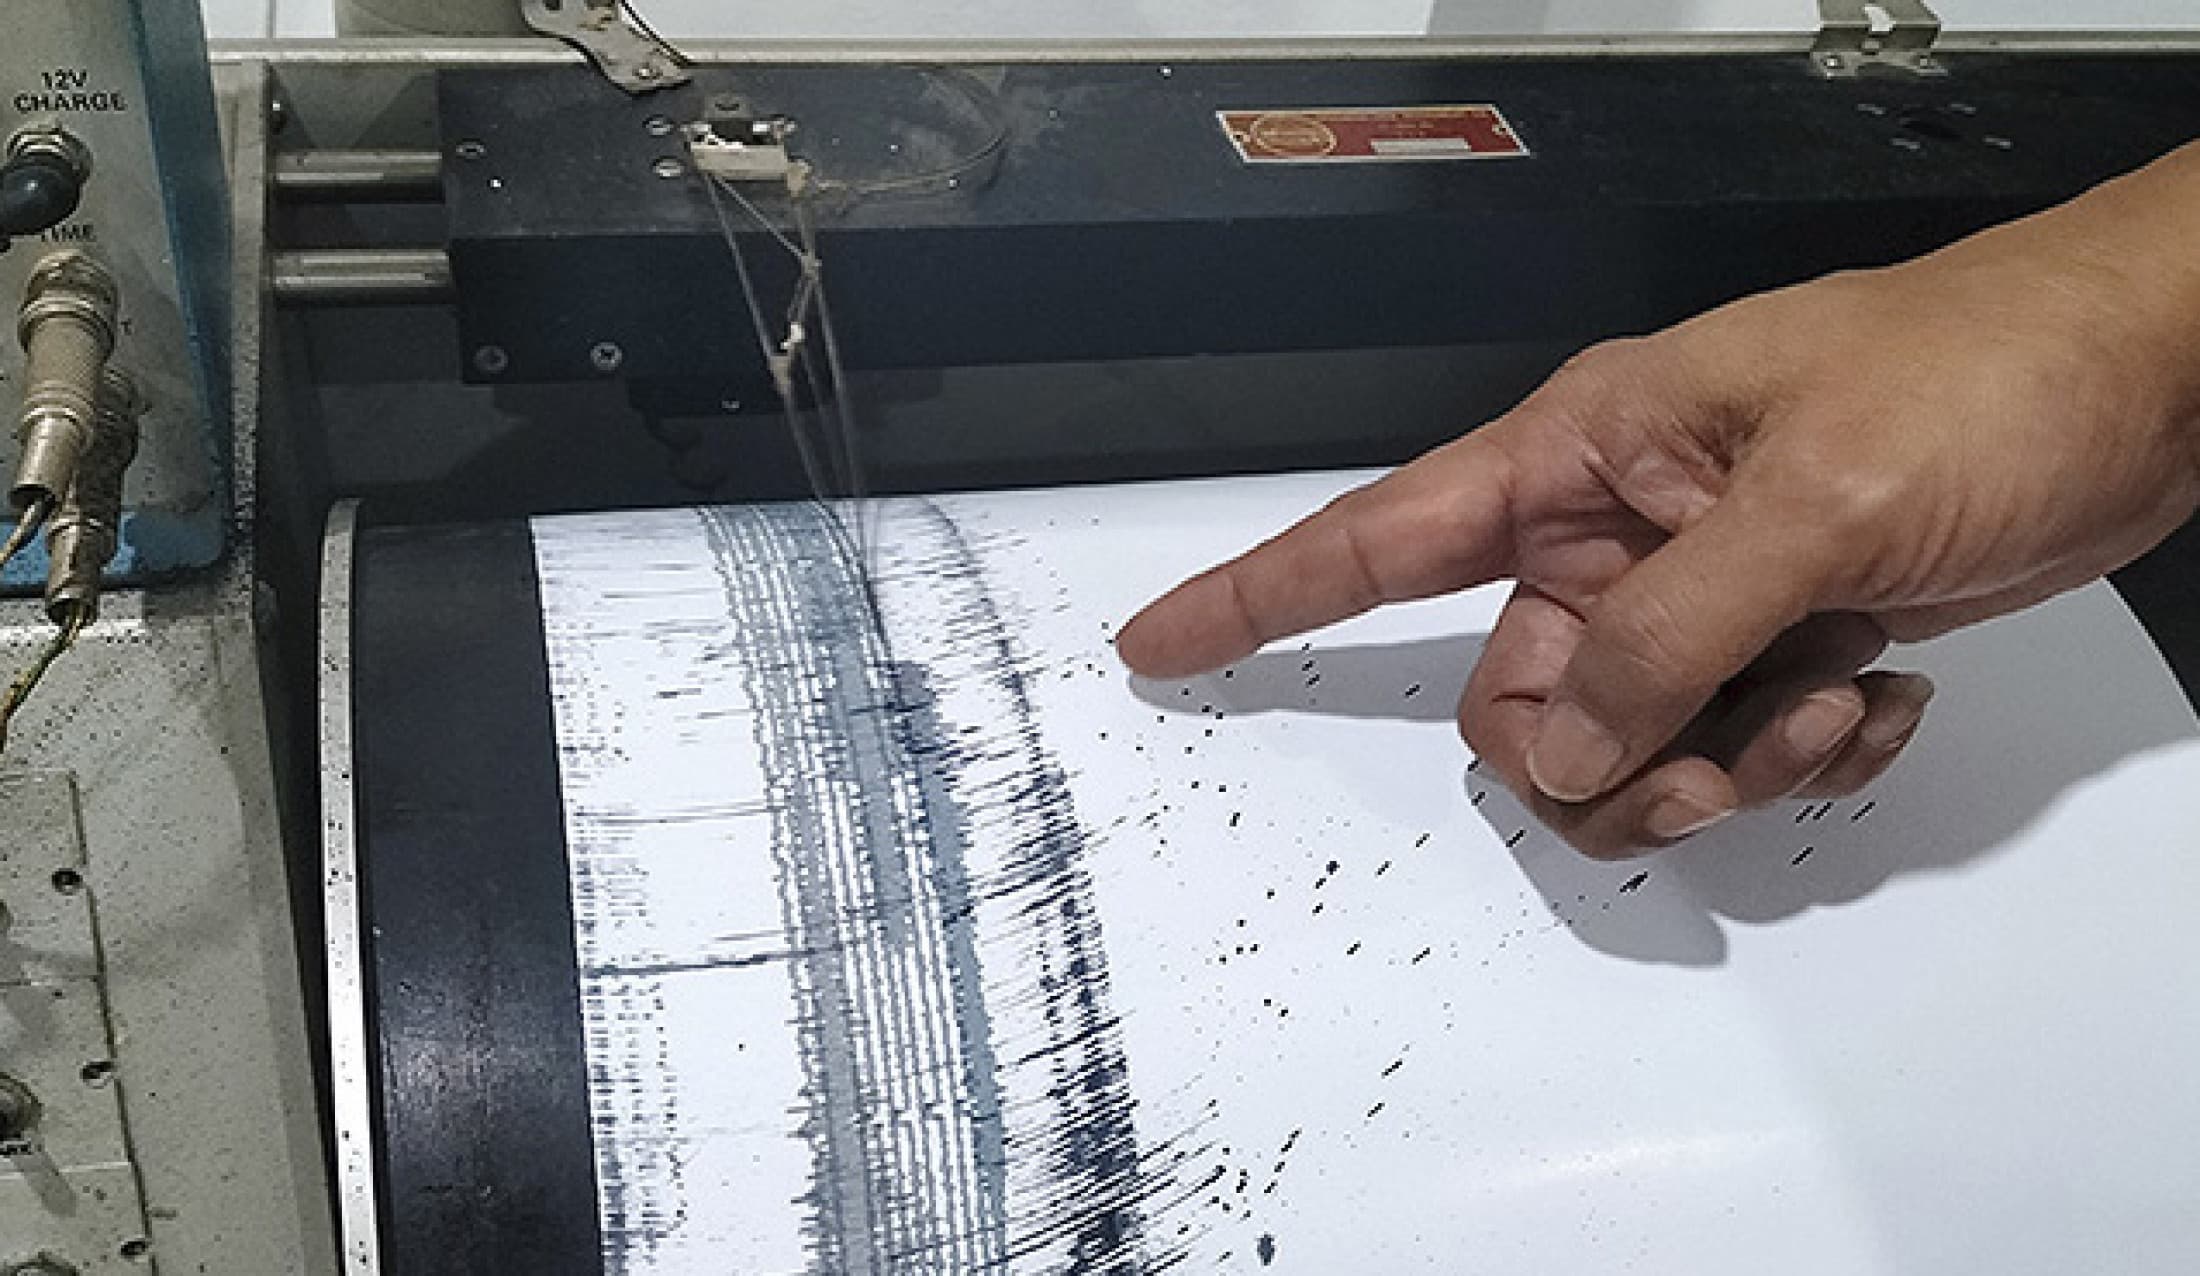
Исследование, проведенное учеными Тель-Авивского университета, позволило выявить сейсмические колебания, вызванные передвижением сил ХАМАСа перед атакой 7 октября 2023 года, пишет Newsru.co.il.
Слабые колебания грунта, вызванные подготовкой к террористической атаке, были выявлены путем анализа характеристик сейсмического шума. Но авторы работы подчеркивают, что идентификация этих сигналов была проведена спустя месяцы после нападения.
Исследование, проведенное под руководством доктора Асафа Инбаля, опубликовано в журнале The Seismic Record.
Доктор Инбаль объясняет: «Израильская геологическая служба управляет общенациональной сетью из десятков высокочувствительных сейсмометров, которые непрерывно отслеживают колебания грунта. Эта сеть предназначена в первую очередь для обнаружения и локализации землетрясений и предупреждения о сильных подземных толчках, вызванных крупномасштабными сейсмическими событиями».
Три станции этой сети, расположенные в Амации, Кциоте и Ятире – на удалении от 30 до 50 километров от границы Газы, зарегистрировали необычные уровни сейсмического шума между 6:00 и 6:30 утра 7 октября 2023 года.
Хотя сейсмометры способны обнаружить даже слабые колебания грунта, доктор Инбаль отмечает, что связать сейсмический шум с движением тяжелого транспорта в Газе стало возможно благодаря очень низкому уровню фонового шума, который установился на юге Израиля ранним субботним утром, совпавшим с праздником Симхат-Тора.
«Хотя музыкальный фестиваль под открытым небом в районе Реима создал некоторый сейсмический шум, наш анализ показывает, что этот шум не соответствует по силе или расположению источникам, зафиксированным израильской сейсмической сетью 7 октября», – говорит доктор Инбаль.
Анализ показывает, что обнаруженный сейсмический шум начался в 6:00 утра и усиливался по мере приближения атаки. Шум содержит достаточно сильные всплески. Их расположение и интенсивность свидетельствуют о движении транспортных средств от Рафиаха на юге до КПП «Эрез» на севере.
«У нас хорошее разрешение вдоль дороги Салах ад-Дин, главной магистрали, пересекающей Газу от Рафиаха на юге до Байт-Лахии на севере. Мы можем с высокой степенью уверенности подтвердить, что их силы двигались по этому маршруту со скоростью от 25 до 50 км/ч. Сейсмические наблюдения свидетельствуют о колоннах тяжелых машин, таких как бульдозеры и грузовики. За три минуты до начала атаки мы видим источники шума, в северной части Газы в районе Байт-Лахии и южной части в районе Хан-Юниса», – говорит доктор Инбаль.
«Мы знаем, что нападение началось практически одновременно вдоль всей границы, и эти сейсмические наблюдения служат дополнительным доказательством широкого развертывания сил ХАМАС», – заключает Асаф Инбаль.
Ученый считает, что в дальнейшем можно применять сейсмические наблюдения в целях обеспечения безопасности.


Можно ли верить медицинской информации в ChatGPT, выяснили ученые Израиля
Использование искусственного интеллекта (ИИ), особенно больших языковых моделей вроде ChatGPT, набирает обороты. Вместе с тем остается важный вопрос: насколько можно полагаться на них в понимании сложной медицинской информации? Не навредят ли советы «доктора с искусственным интеллектом»? Ответ на эти вопросы дает новое исследование, проведенное в Израиле и опубликованное в научном журнале Computers In Biology and Medicine.
Исследование проводилось учеными университета имени Бен-Гуриона в Негеве. Оно проверяло возможность моделей ИИ давать точные ответы на медицинские вопросы. Проверялась способность ChatGPT и его аналогов правильно понимать язык медицины. Результаты удивили ученых.
Сейчас медицинский чатбот отвечает на вопросы пациентов, предсказывая развитие болезней, создает сводные данные о больном и готовит вопросы и ответы для студентов-медиков. Но поскольку модели ИИ в области медицины стали распространенными, возникают вопросы критической важности: может ли ИИ разбираться в тонких различиях между близкими по смыслу медицинскими терминами? Особенно если речь идет о медицинских кодах, которые необходимо точно понимать на высоком уровне. Для проверки ученые сравнили разные моделей ИИ, в том числе те, что специализируются в области медицины.
Для сравнения была создана целевая система оценки - MedConceptsQA, содержащая 800.000 вопросов и ответов трех степеней сложности, относящихся к применяемым во всем мире медицинским понятиям. Была поставлена задача выяснить, как модели ИИ интерпретируют эти понятия и различают их. Понятия относились к сфере диагностики, лечебных процедур и медикаментов. При помощи разработанного алгоритма были автоматически созданы вопросы с переменным уровнем сложности, для ответа требовалось выбрать правильный медицинский код. Если простые вопросы требовали наличия базовых знаний, то для ответа на сложные нужно было глубокое понимание и умение находить даже небольшие различия между схожими медицинскими понятиями. Вопросы средней сложности требовали более высокого уровня базовых знаний.
Исследование показало, что большинство моделей ИИ дает плохие результаты, основанные на случайных догадках. Это относилось и к моделям ИИ, разработанным специально для использования в медицине и содержавшим большие объемы медицинской информации. А вот ChatGPT4 показал лучшие результаты, его точность была в среднем равна 60%, но и это далеко от удовлетворительного уровня.
К удивлению ученых, модели не медицинского, а общего назначения, такие как ChatGPT4 и Llama3-70B, выдавали лучшие результаты. Отсюда можно сделать вывод: модели ИИ, занятые расшифровкой словесных текстов, эффективны в классификации информации, но когда речь идет о жизненно важной клинической информации, необходимо глубокое понимание сути медицинских кодов и их различий. Это понимание имеет критическое значение в ранней диагностике и в спасении жизни.
Исследование позволило оценить способность чатботов к интерпретации медицинских кодов и различению медицинских терминов. Доказано, что большинство медицинских моделей ИИ выдает ответы, соответствующие случайному угадыванию человеком, зато ChatGPT3.5, ChatGPT4 и Llama3-70B превосходят их, хотя их кодировка не имеет отношения к медицине.
Клинические данные в большинстве своем включают стандартные медицинские коды и тексты на естественном языке. Израильское исследование подчеркивает необходимость более обширного клинического языка для понимания медицинской информации и осторожность, необходимую при их широком использовании. Результаты этого исследования имеют практическое значение для современного медицинского мира. Удивительные результаты исследования поднимают серьезные вопросы, которые волнуют многих ученых: следует ли использовать медицинские модели ИИ для составления прогнозов, требующих клинического понимания медицинских кодов.
vesty.co.il